一、前言
在前不久的蓝戟Arc Pro B65单卡评测里我曾过,虽然B65仅有20个Xe核心、197 TOPS INT8算力,但它的价值远不在此,而在32GB大显存。27B级别的FP8模型在一张B65上刚刚能装下,权重之外留给KV Cache的余量只够约8K上下文。再长,就是Out Of Memory。
于是便产生了一个问题:把两张B65插在同一台机器上,显存是不是简单地变成64GB?同样的Qwen3.8-27B-FP8能不能从8K一路跑到128K?而在桌面平台没有NVLink、卡间只能走PCIe的前提下,张量并行(TP)、流水线并行(PP)、数据并行(DP)这三种模式,到底哪种真的好用?
本次我将用两张蓝戟Arc Pro B65 32G显卡,把上面这些问题逐一回答。
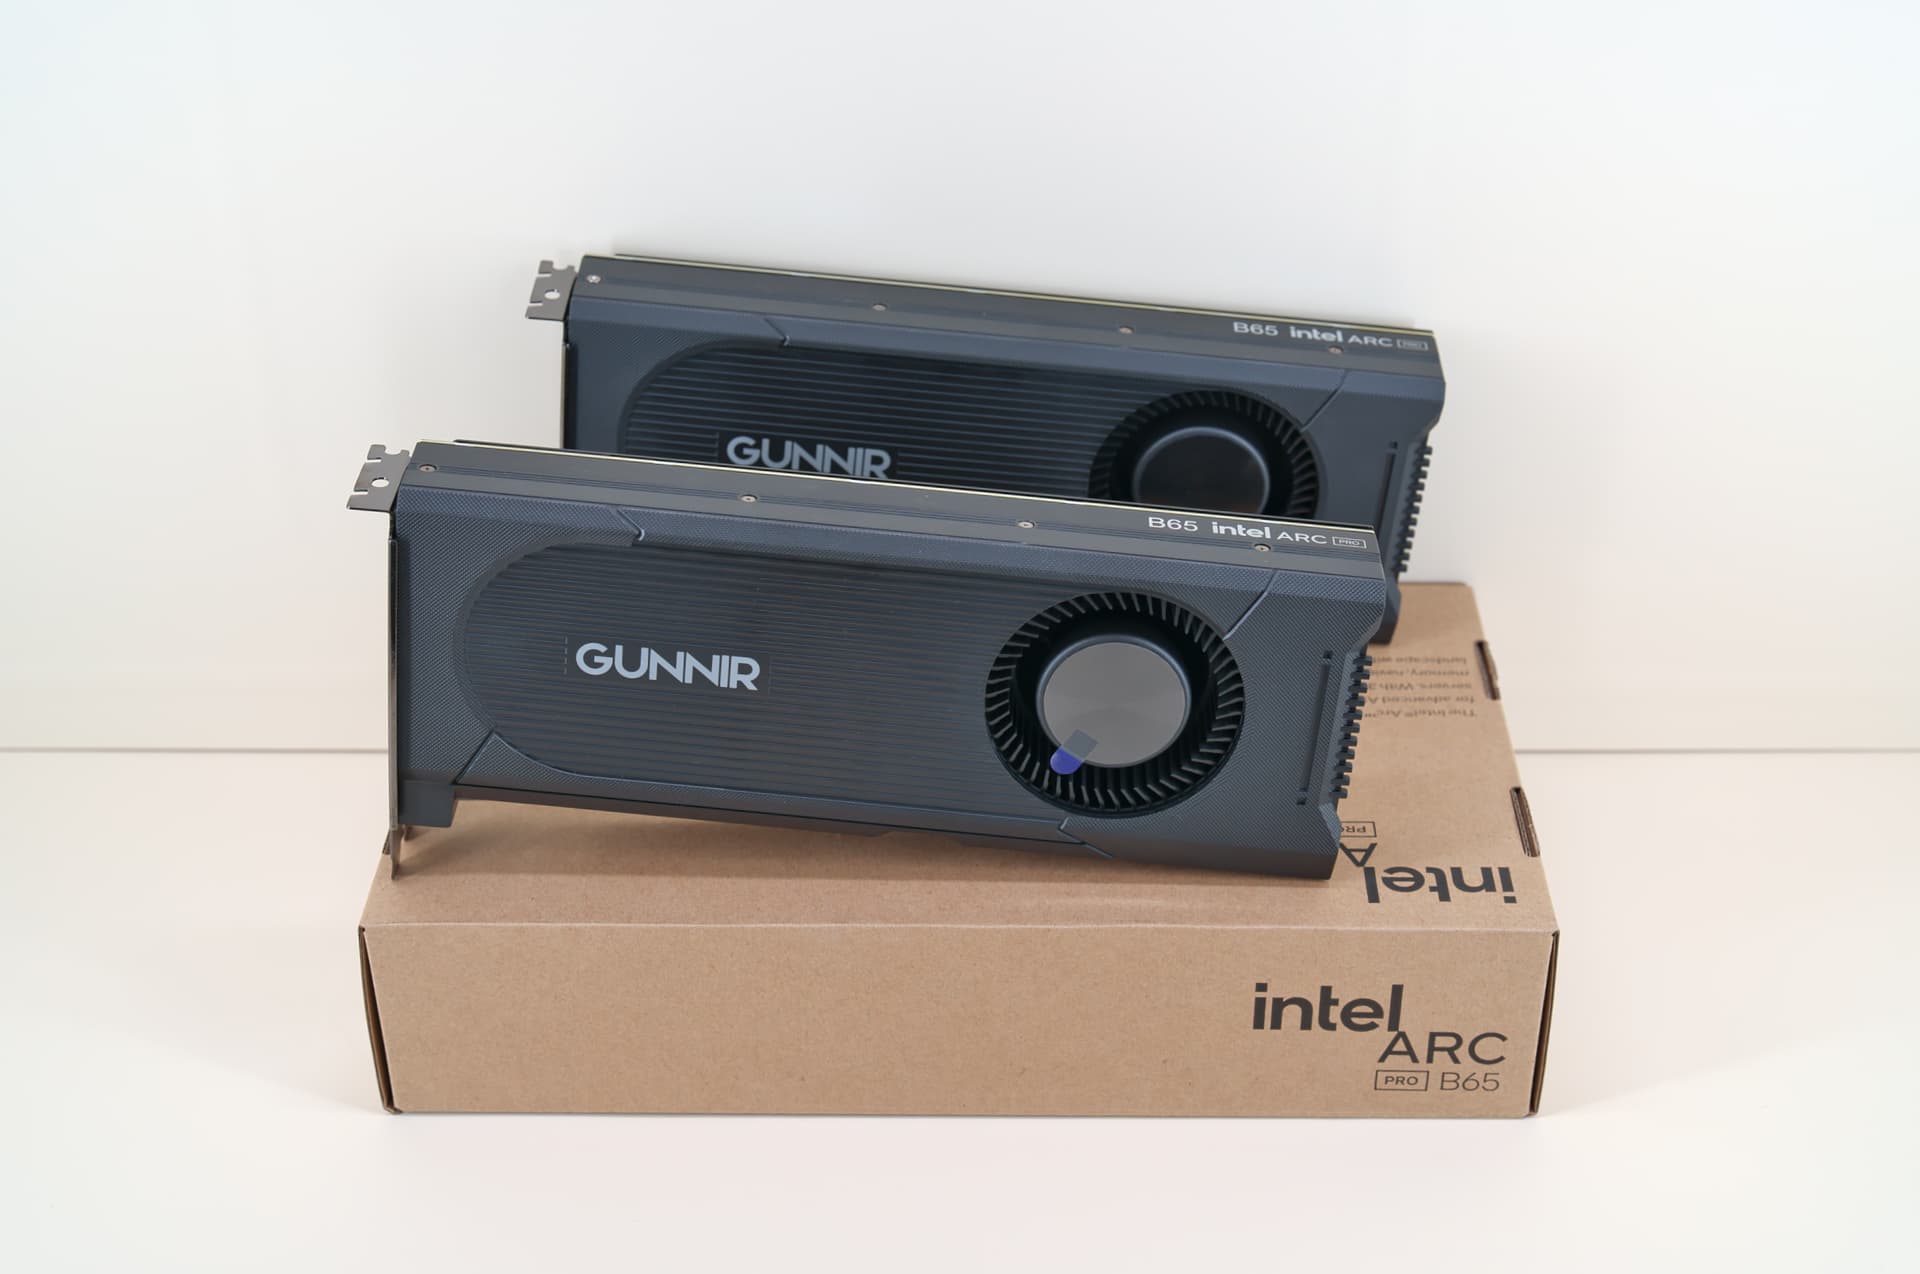
二、运行环境
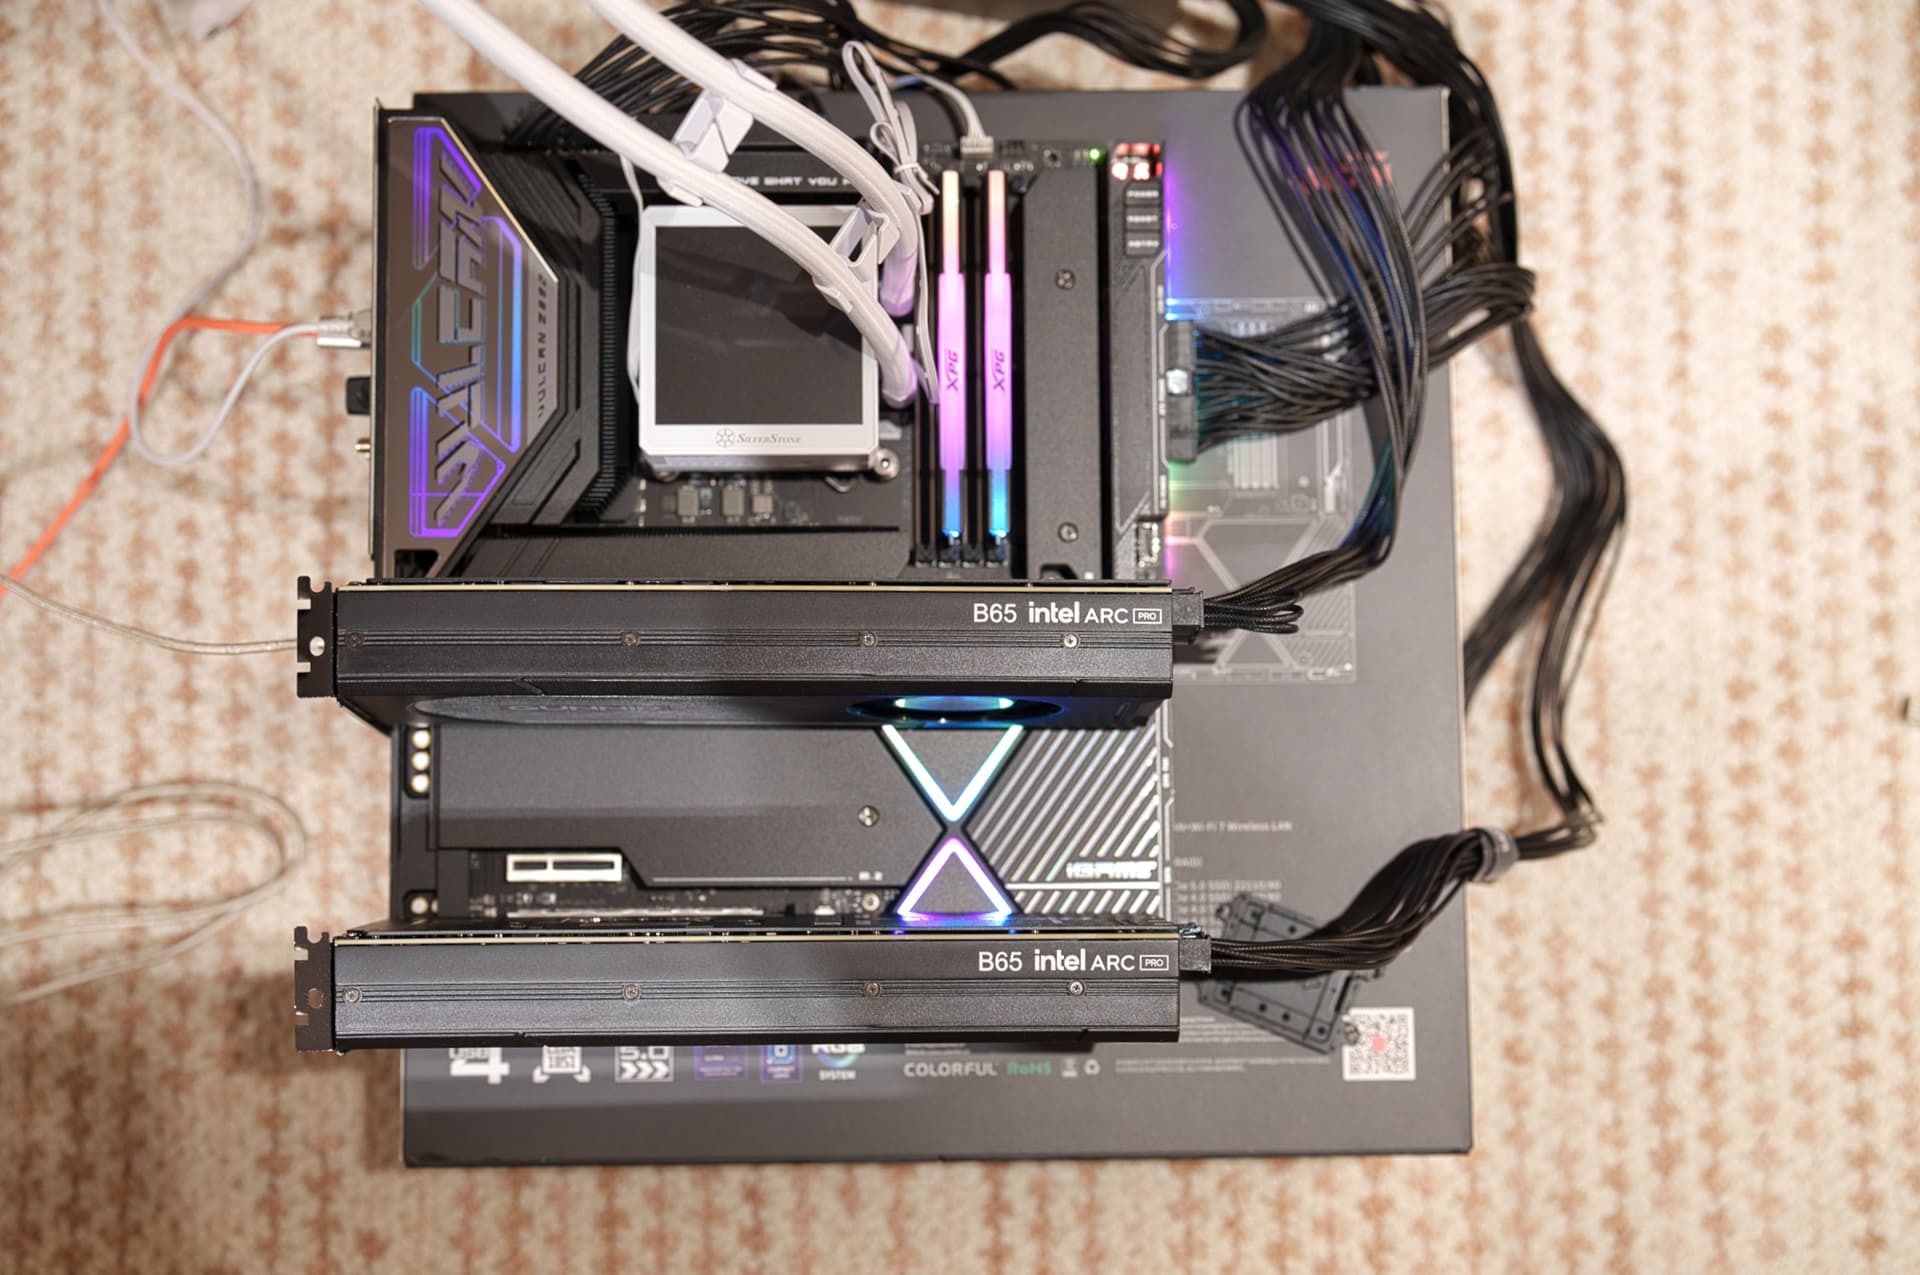
(一)硬件环境:双直通PCIe插槽的主板
在张量并行模式下,每一层的前向计算都要在两张卡之间交换激活值与KV Cache,通信量随batch与层数线性放大;流水线并行按层切段,每生成一个微批次也要在卡间send/recv。真正跑起来之后,两张卡不是各干各的,而是每算一步都要互相喊话,这条 “喊话” 的通道,就是PCIe。
而桌面平台的PCIe插槽却有两种常见形态,CPU PEG通道直连处理器、延迟最低;而走PCH的槽全部共享DMI上行。然而值得注意的是,虽然Intel在CPU层面支持将5.0 x16拆分为8+8,然而目前主流的Z790/Z890出于设计难度与制造成本考虑,大部分都只提供一条直连CPU的PCIe插槽,只有部分旗舰型号才会设计两条直连PCIe插槽,我经手过的Z890主板也不算少了,只有华硕ROG Maximus Z890 Extreme和七彩虹iGame Z890 Vulcan X 火神才有这样的配置,而本次测试使用的主板便是后者。

(二)软件环境:Ubuntu+Docker+llm-scaler-vllm
Intel显卡的多卡推理栈,一年前还只是散落在各个仓库里的实验性补丁,如今已经有了相对完整的官方路径。
目前vLLM上游已经把Intel XPU列为一等公民后端,与CUDA、ROCm、Apple Silicon并列。对B系列专业卡,Intel主推的发行方式不是让用户自己pip install,而是容器。LLM Scaler就是面向Arc Pro B系列的预装推理镜像套件:llm-scaler-vllm内部是在vLLM之上叠加了Intel定制patch与定制ESIMD kernel,卡间通信走oneCCL。启动时必须带VLLM_WORKER_MULTIPROC_METHOD=spawn、–shm-size 32g(给CCL进程间通信预留共享内存),BKC基线是Ubuntu 25.04 + kernel 6.14、BIOS开Resizable BAR、P2P最佳性能需要GRUB里intel_iommu=off。
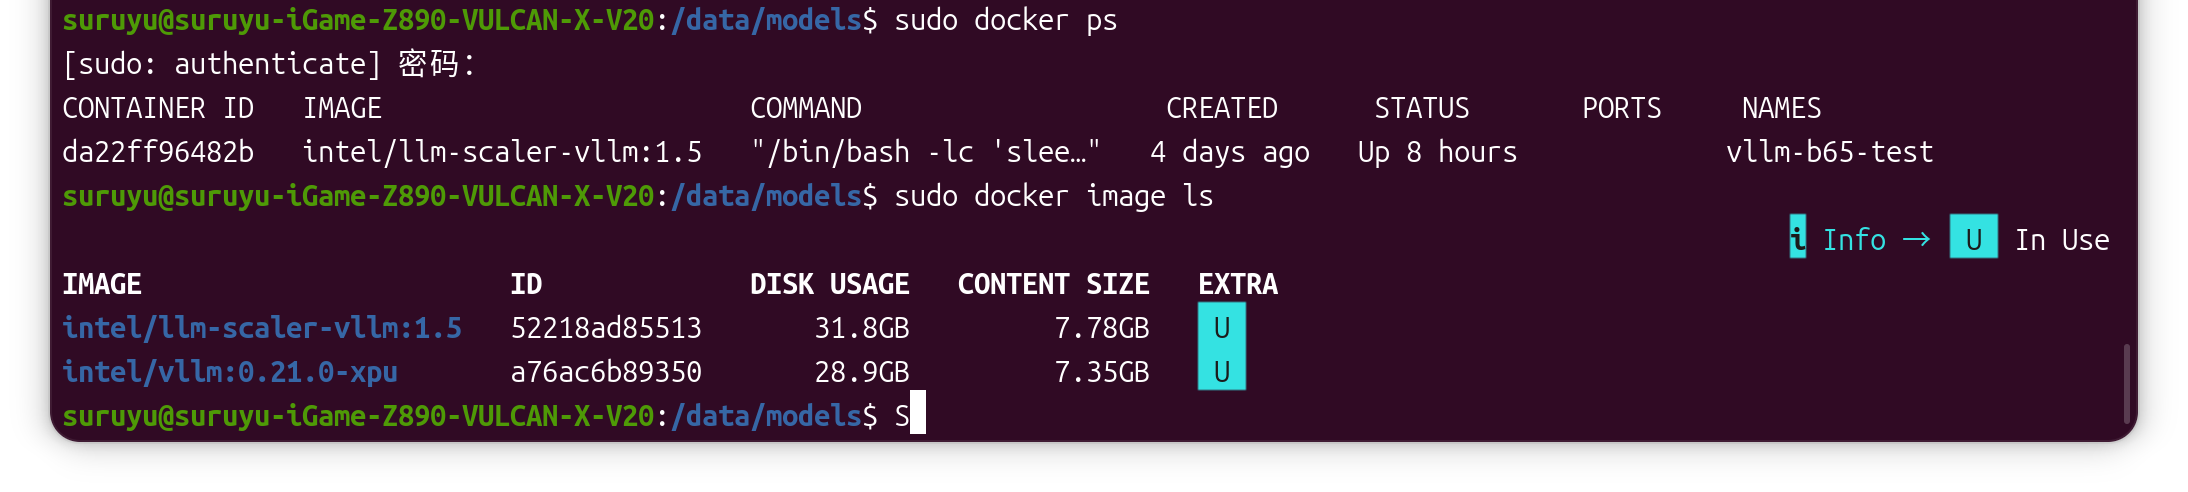
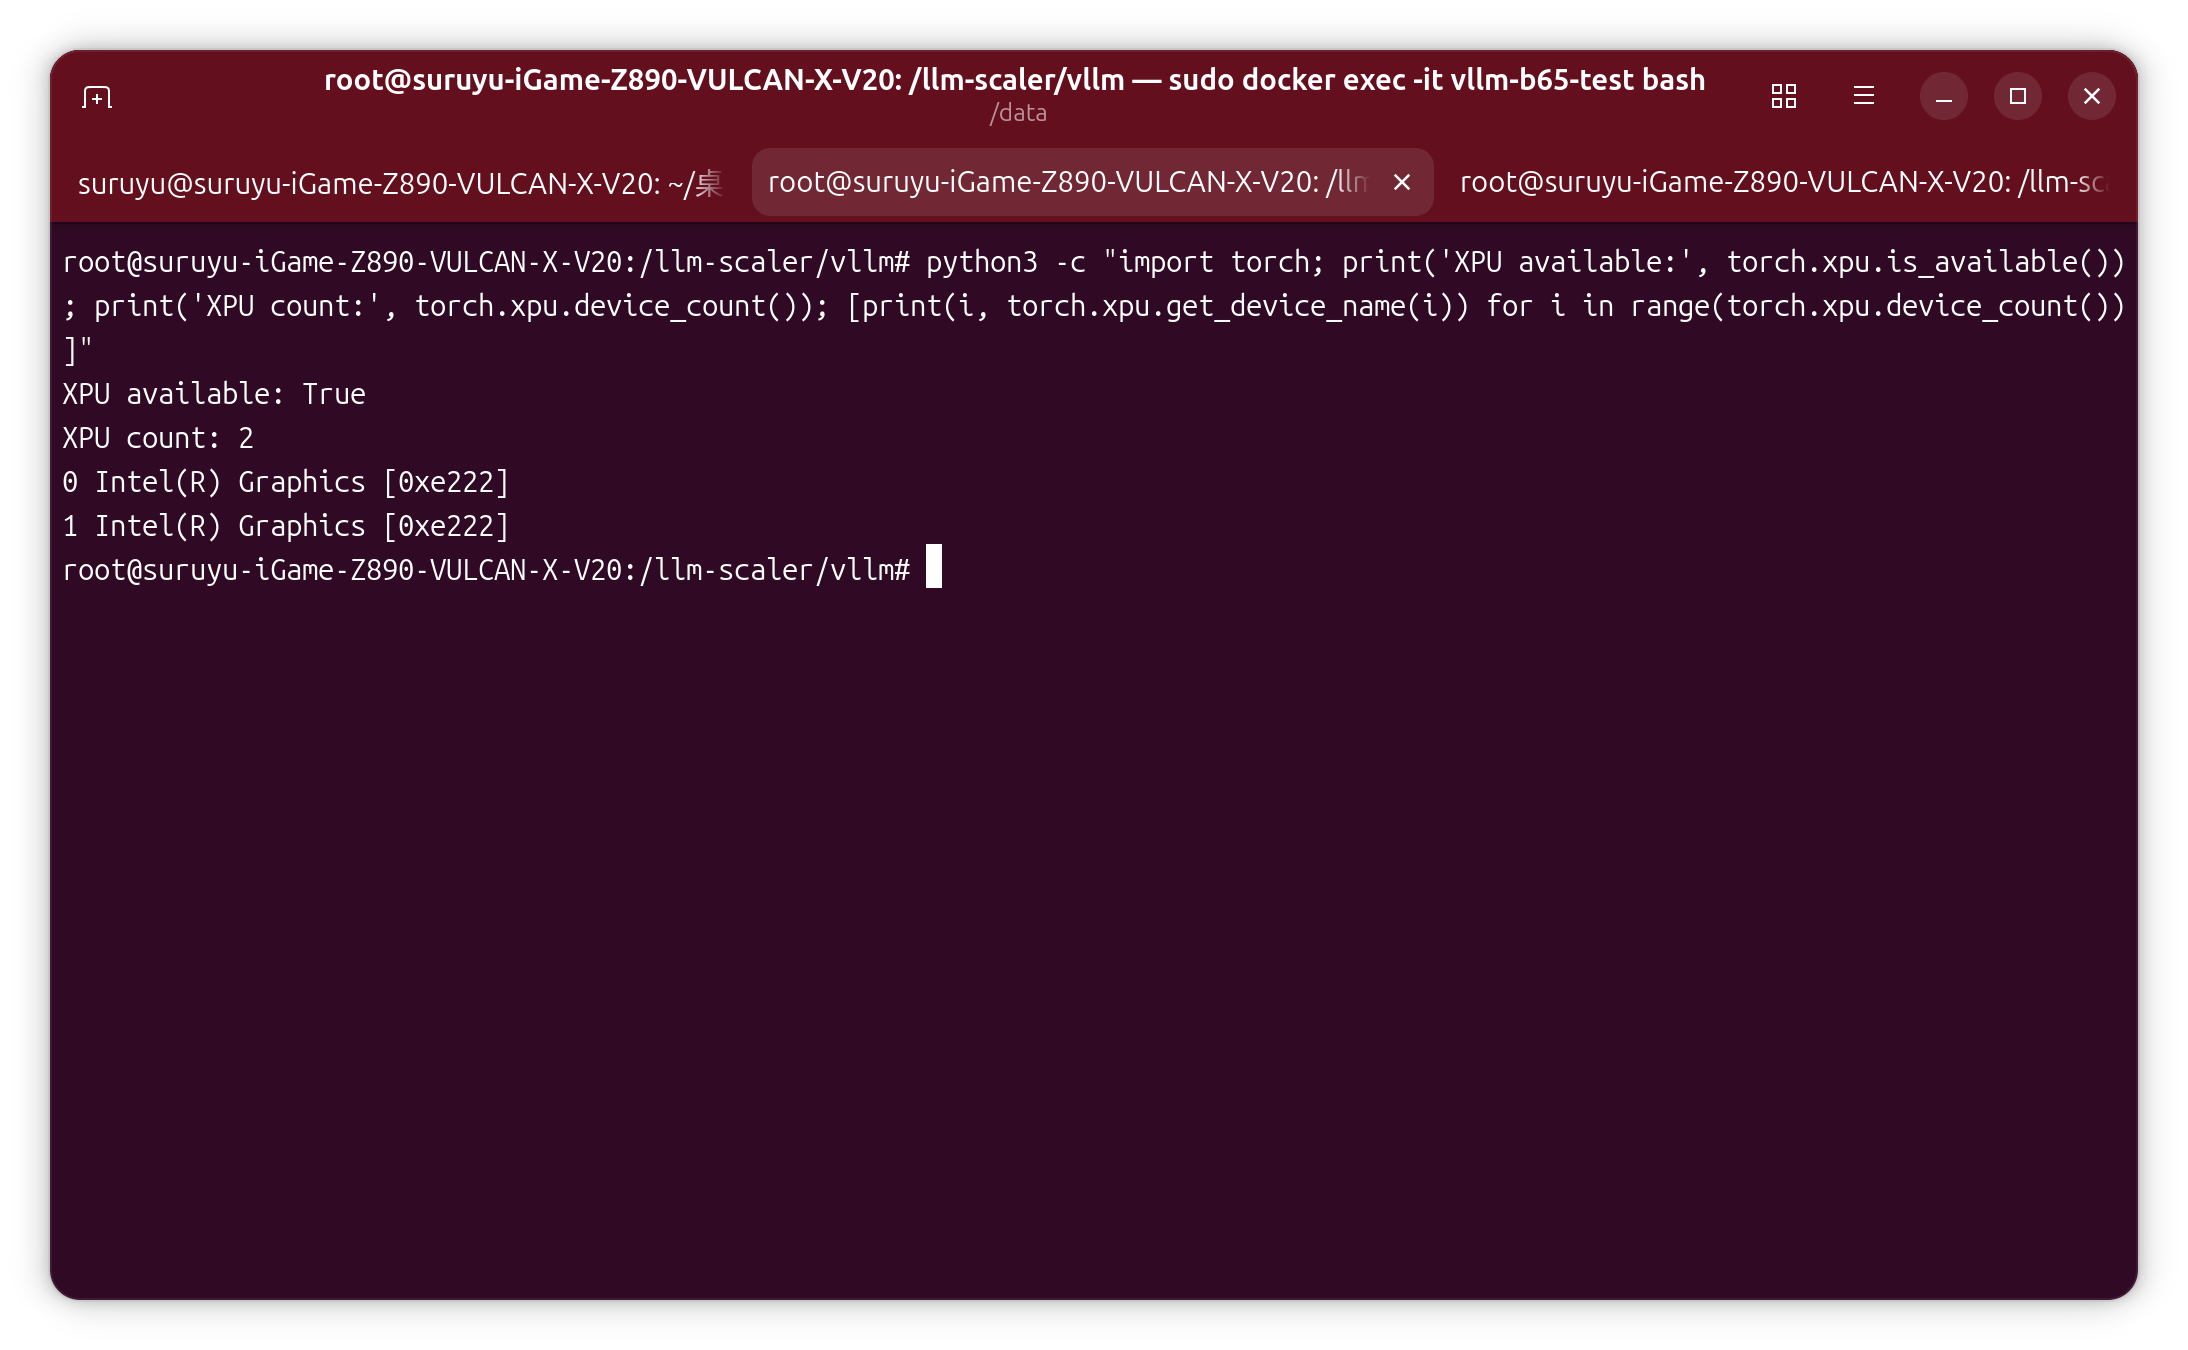
软件栈采用了Ubuntu 26.04环境下Docker拉取intel/llm-scaler-vllm:1.5镜像,容器以–net=host --device=/dev/dri --shm-size=32g启动,容器内设置VLLM_TARGET_DEVICE=xpu、VLLM_WORKER_MULTIPROC_METHOD=spawn。单卡直接vllm serve;张量并行加–tensor-parallel-size 2;流水线并行加–pipeline-parallel-size 2;数据并行则加–data-parallel-size 2。
(五)三种并行模式:原理与取舍
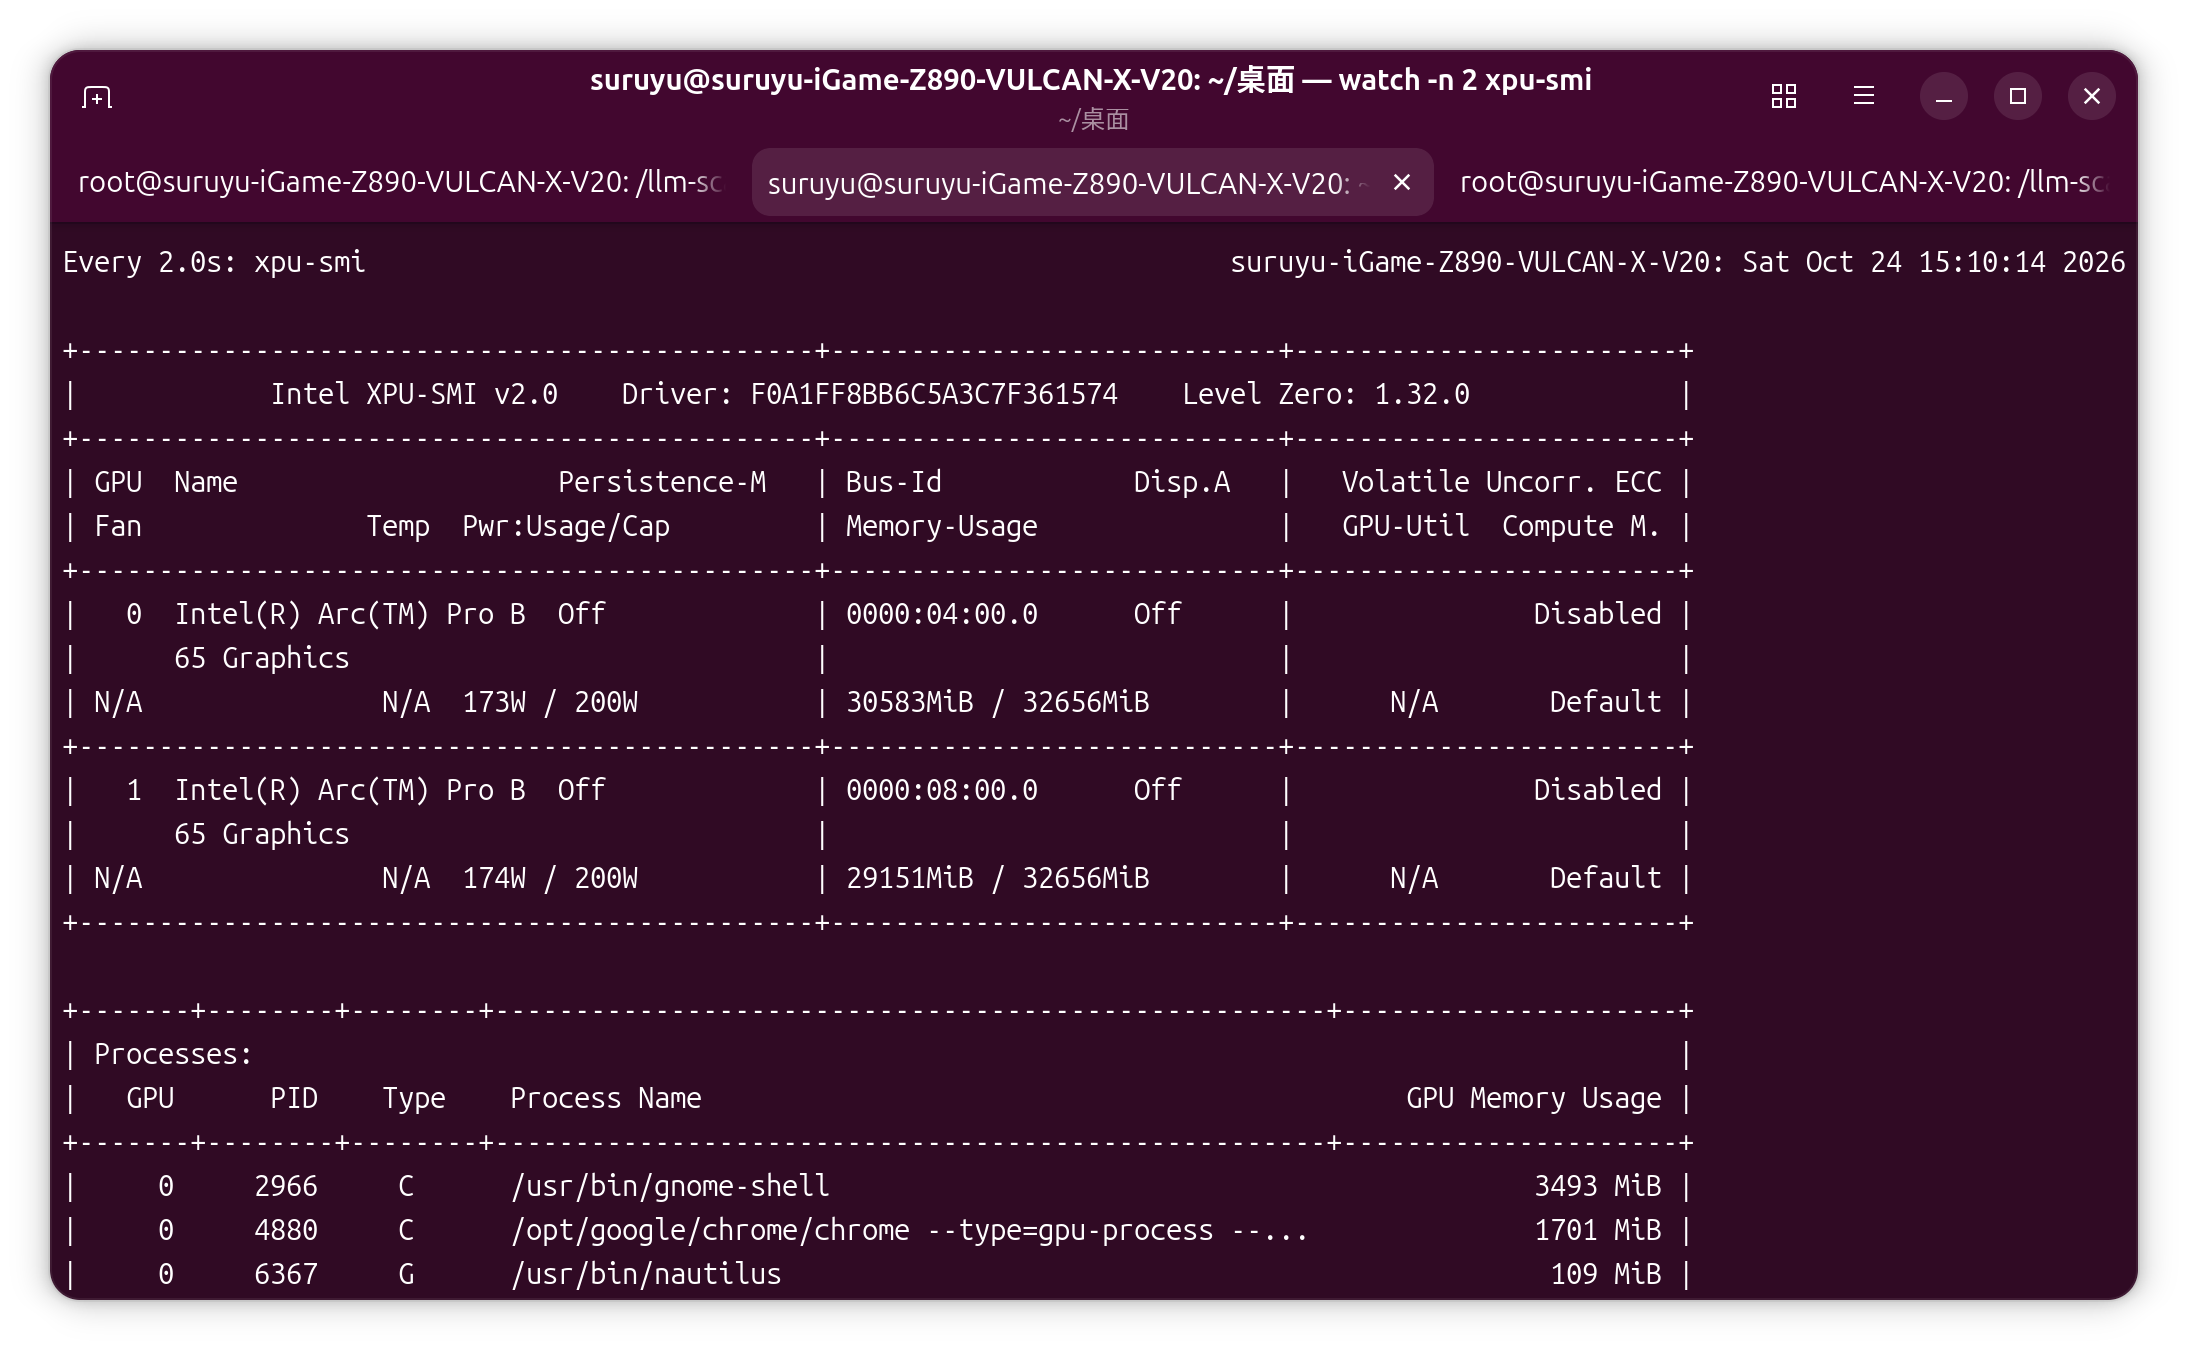
TP(张量并行):把模型权重按层内切到两张卡上,每一层前向都要allreduce一次。好处是两张卡的显存真正叠加——权重各背一半,KV Cache也分摊,上下文容量接近翻倍,代价是每一步都有卡间通信。在跑单并发的时候双卡的显存和TBP功率基本打满,负责状态良好。
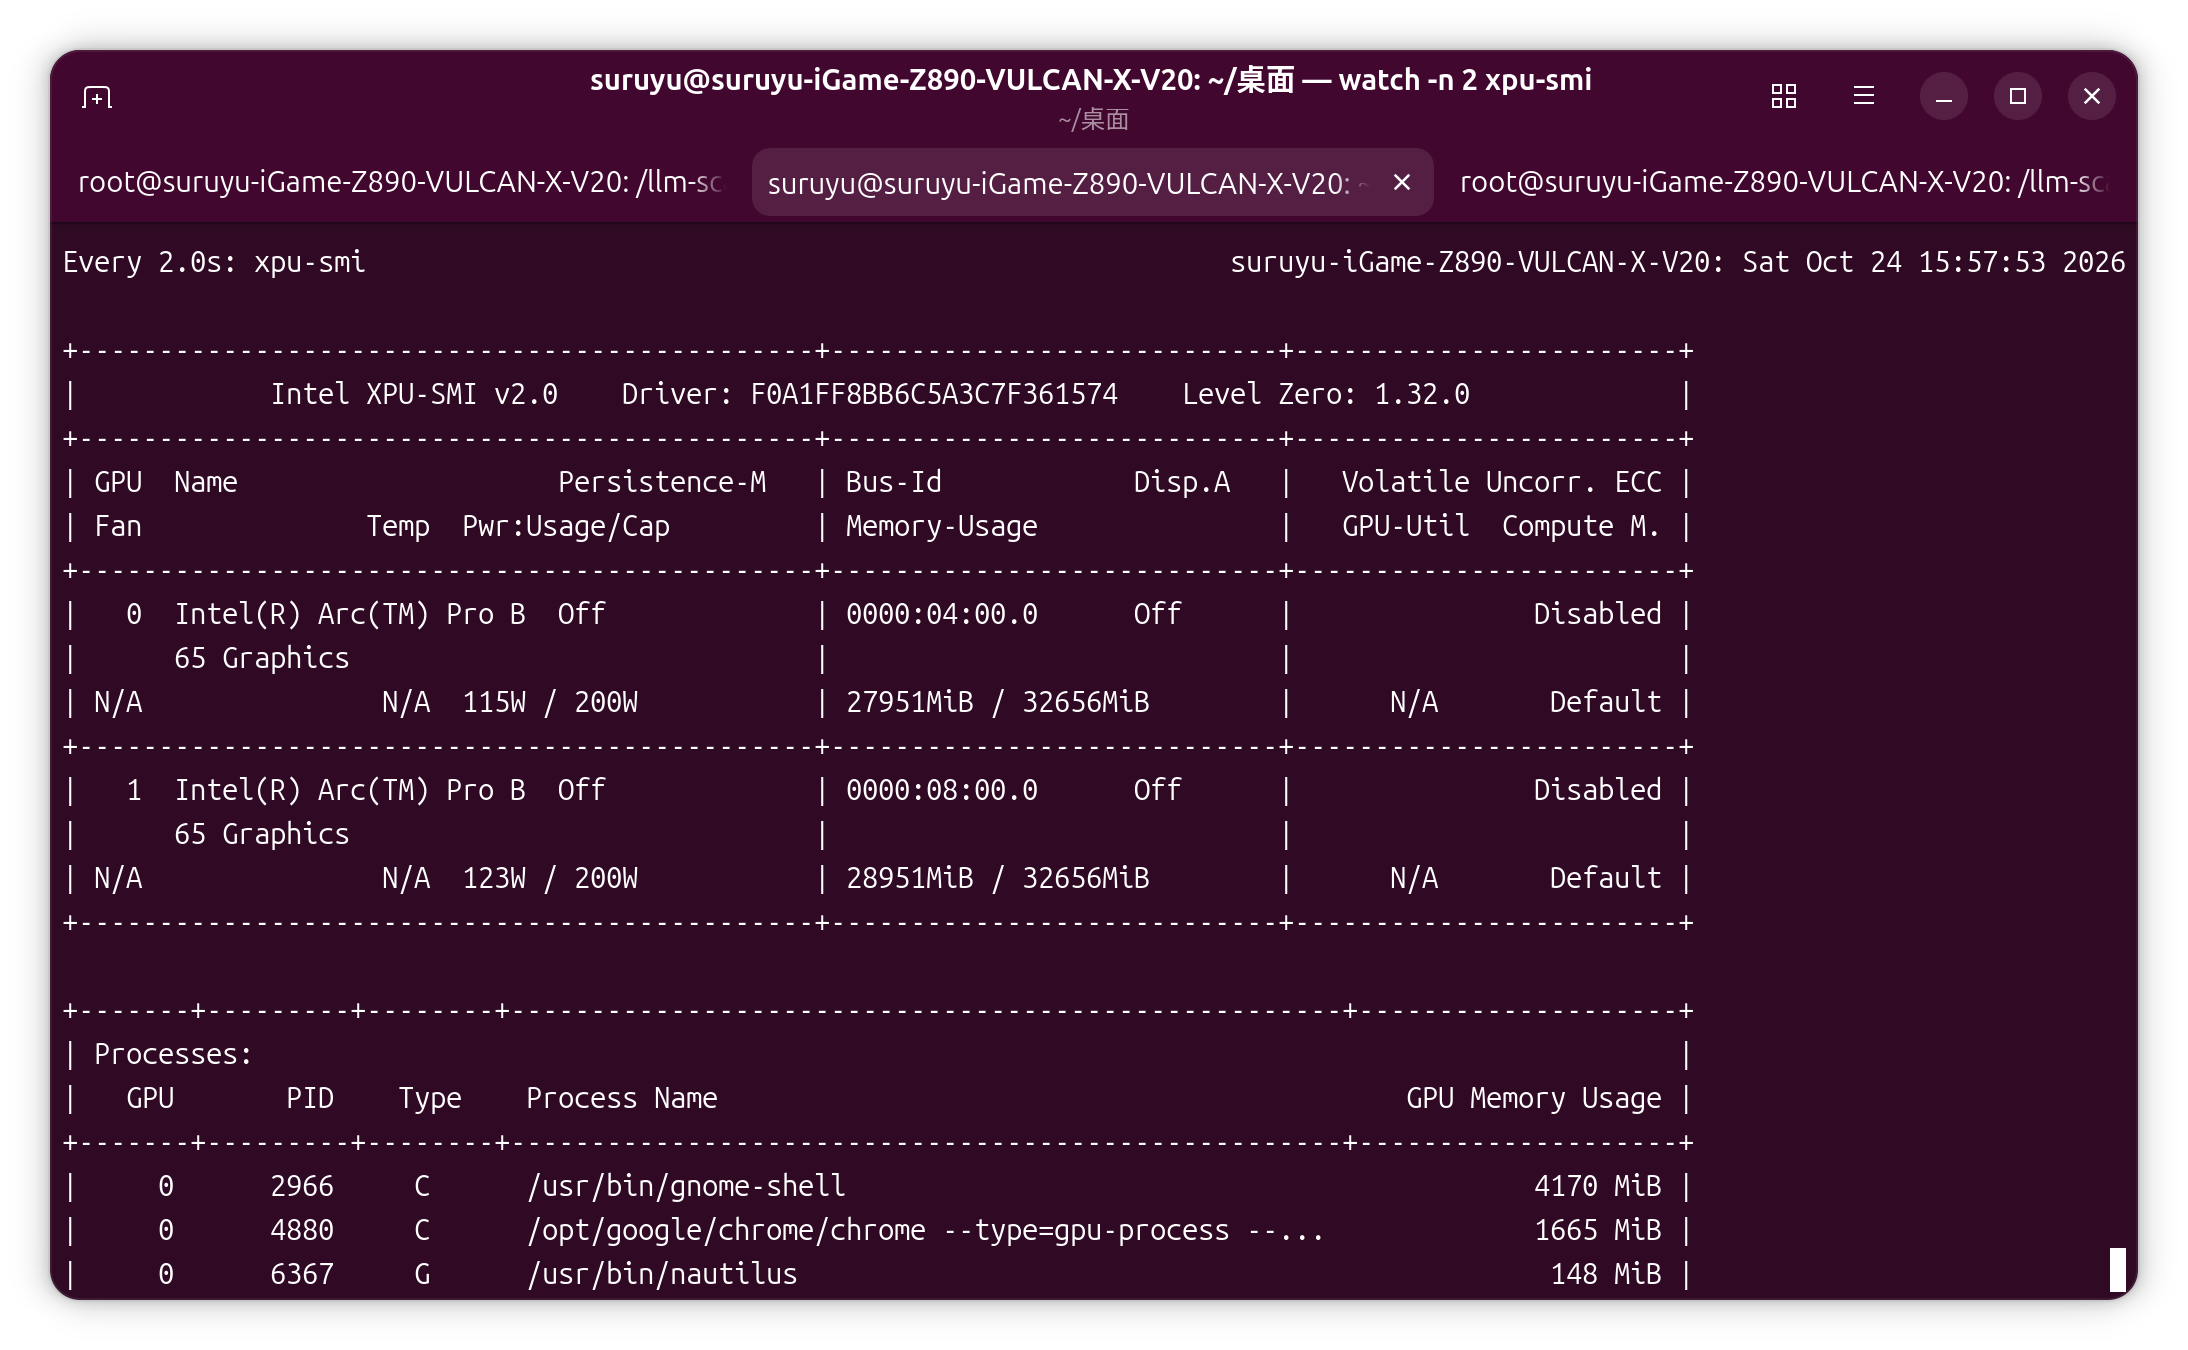
PP(流水线并行):把模型按层切成前后两段,第一张卡管前几层、第二张管后几层,请求按微批次在流水线上传递。显存也是叠加的(只切层不分片),但存在 “流水线气泡”,也就是第一个微批次流经前段时,后段卡在等,反之亦然;单请求要串行穿过两段,天然更慢。从下面的xpu-smi监控图可以看到,单并发不能让双卡都跑满,TBP功率只跑到了60%左右。
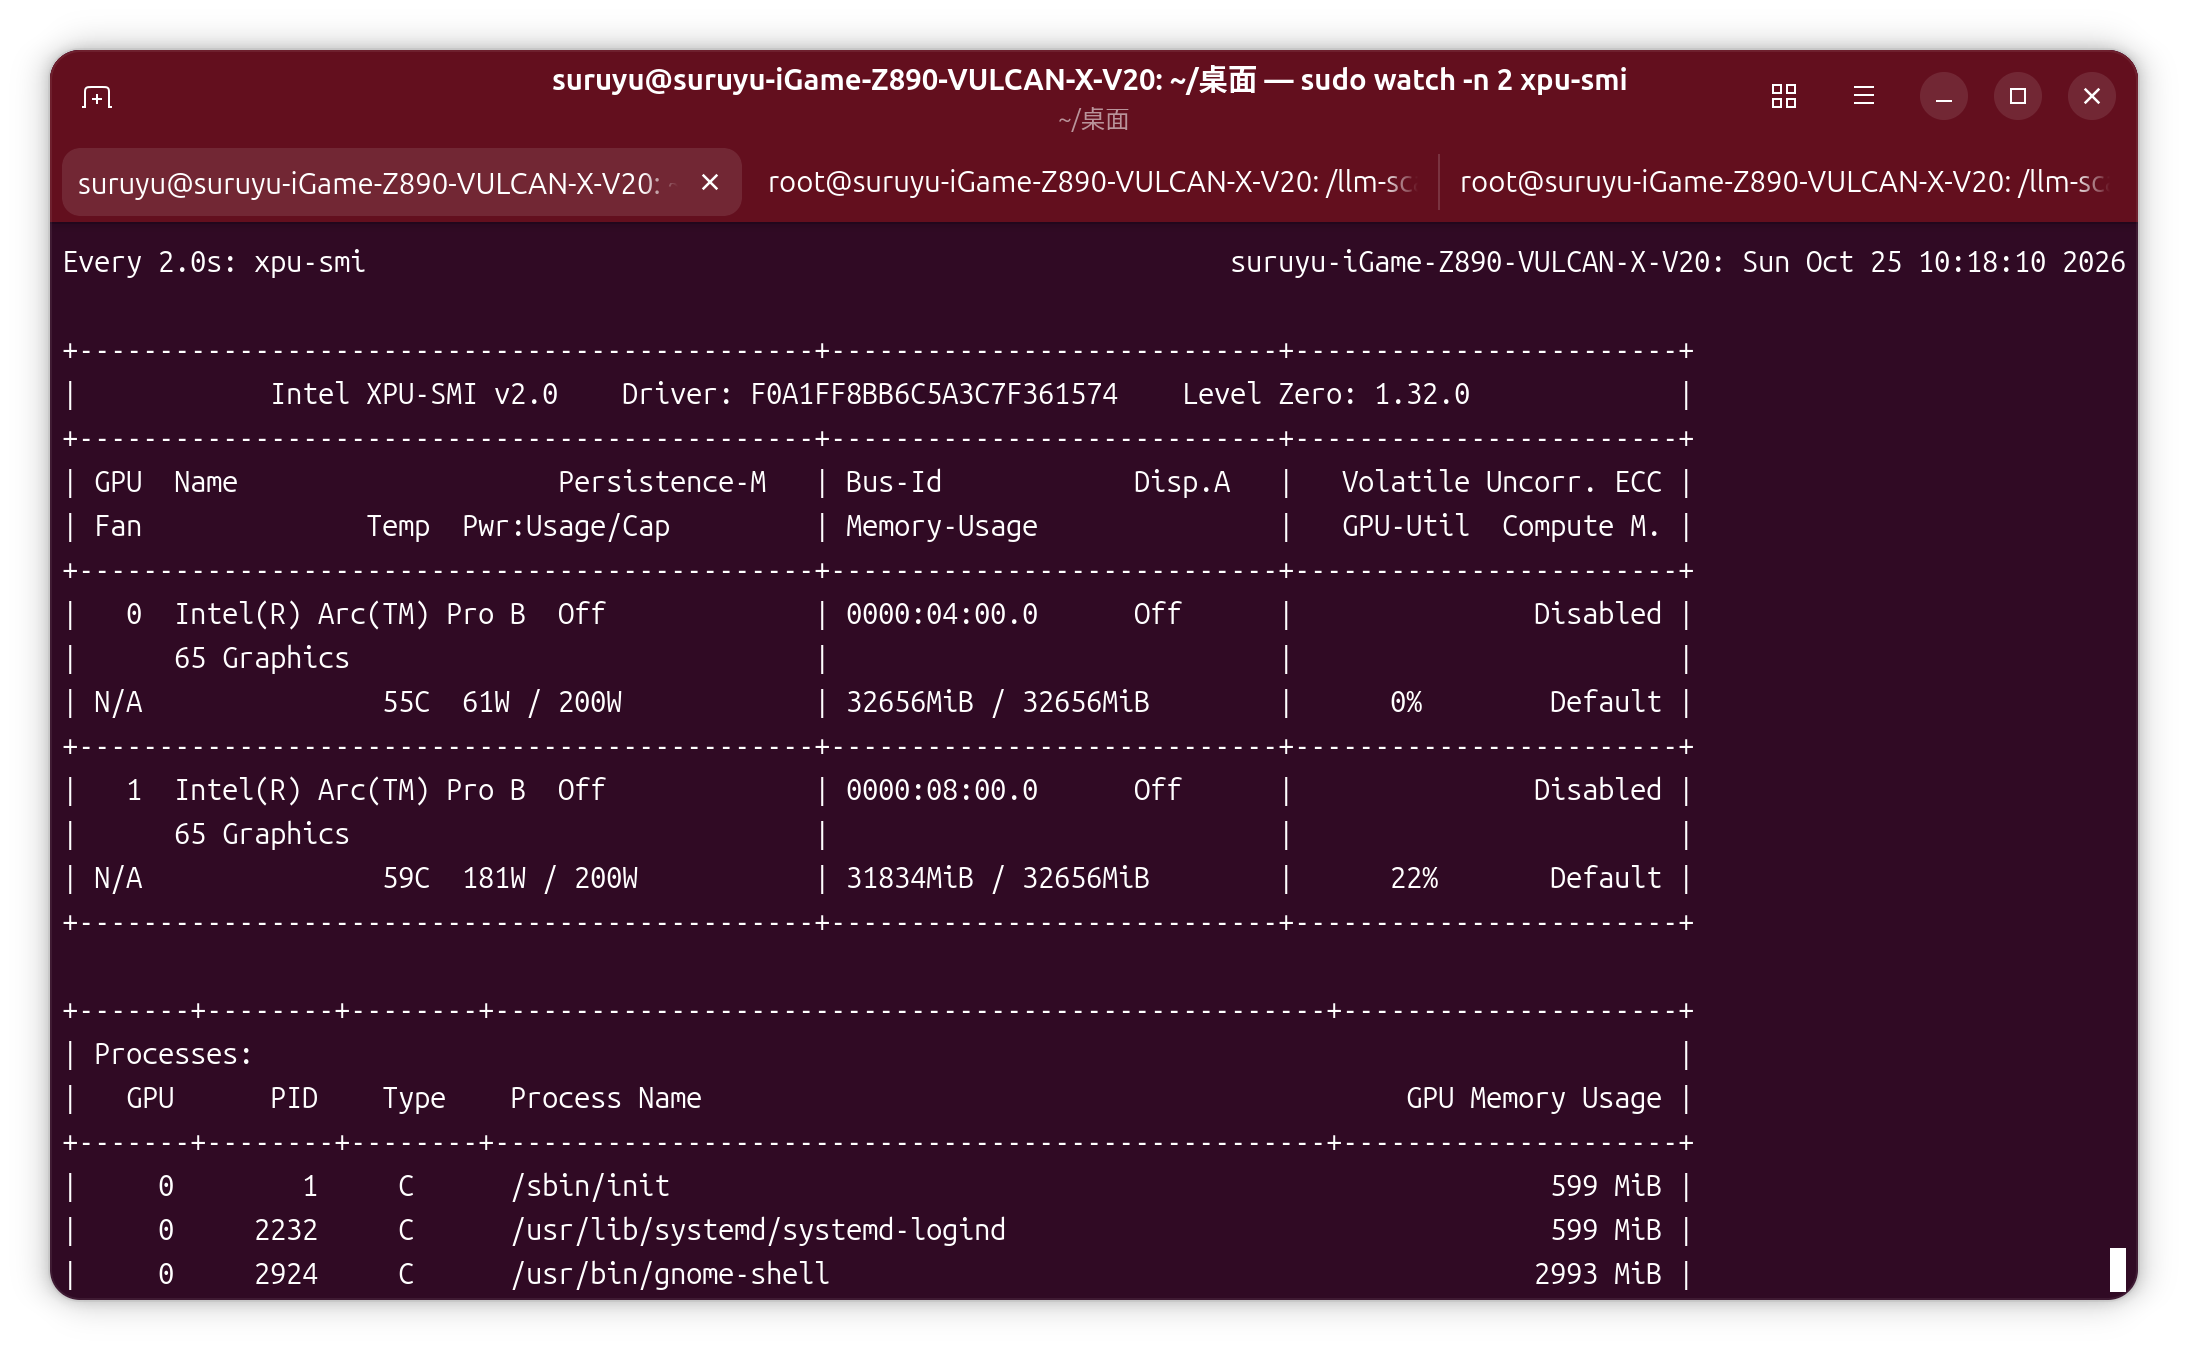
DP(数据并行):两张卡各自加载一份完整模型、各自对外提供服务,前面挂一个负载均衡。显存不叠加(每张卡仍是完整32GB负担),好处是零卡间通信、部署最简单;坏处是上下文没有扩容,且两实例一旦负载不均,性能就会抖动。从下面的xpu-smi监控图可以看到,单并发完全是一张显卡满载,而另一张则在看戏。
三、实测
(一)测试方法与模型
使用自编python脚本,压测脚本本身不起vLLM server,只做客户端打流,逐次调用vllm bench serve(backend vllm、host 127.0.0.1),日志全部落盘,再从vLLM统计块里抠指标。
并发测试的构造是:随机token数据集(–dataset-name random),输入长度固定2048、输出固定128(–ignore-eos强制生成满128);并发点取c=1/2/4/8,request-rate inf打满队列;prompt数= max(40, 并发×10),即c=1/2/4各40条、c=8为80条;每个点重复两轮。prefill扫描则是输出压到1个token、并发1、10条prompt,长度梯度512/1024/2048/4096/6144,单轮,目的是把TTFT主要归因于prefill计算。
模型选Qwen3.8-27B-FP8,理由很直接:27B稠密模型FP8量化后权重约28GB,单张32GB B65刚好装下、KV余量撑约8K;双卡并行时KV与权重分摊,上下文可以开到128K以上。它正好卡在 “单卡顶到天花板、双卡才够用” 的甜点位。

(二)并发吞吐:聚合decode随并发变化
表1四模式聚合decode吞吐(Output token throughput,tok/s;两轮成功记录取算术平均)
| 并发 | 单卡r1/r2 | 单卡均值 | TP r1/r2 | TP均值 | PP r1/r2 | PP均值 | DP r1/r2 | DP均值 |
|---|---|---|---|---|---|---|---|---|
| c1 | 15.51/15.50 | 15.51 | 21.00/21.05 | 21.02 | 13.80/13.80 | 13.80 | 13.87/14.13 | 14.00 |
| c2 | 15.52/15.52 | 15.52 | 31.72/31.72 | 31.72 | 19.95/19.99 | 19.97 | 21.87/28.45 | 25.16 |
| c4 | 15.52/15.52 | 15.52 | 46.37/46.73 | 46.55 | 24.04/24.04 | 24.04 | 36.78/37.16 | 36.97 |
| c8 | 15.52/15.52 | 15.52 | 61.36/61.39 | 61.38 | 45.69/45.66 | 45.67 | 32.98/32.96 | 32.97 |
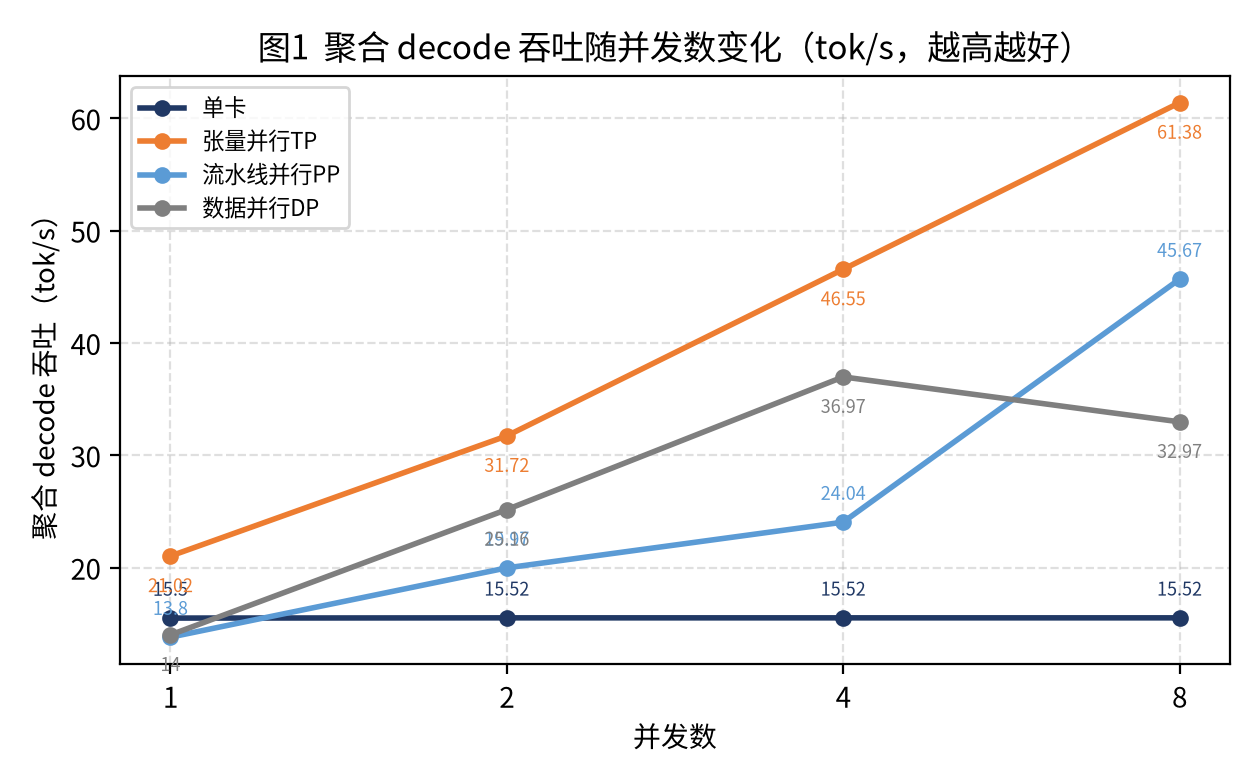
这张表里最扎眼的是单卡一行:从c1到c8,聚合吞吐15.51 → 15.52 tok/s,几乎纹丝不动。这不是测量误差,而是结论:27B-FP8在单张B65上,c=1时decode算力就已经打满,再加并发只是在排队——mean TTFT从1.40s线性膨胀到56.25s,而mean TPOT恒定53.96ms、p99 ITL恒定约55.9ms,没有任何调度尾延迟。加并发只排不跑,就是这个意思。
TP是四条线里最漂亮的:21.02 → 31.72 → 46.55 → 61.38 tok/s,c1到c4近乎线性,c4到c8开始边际递减(+32%),代价是c8时mean TPOT从37.08ms涨到78.52ms。PP起步13.80 tok/s甚至低于单卡——这是流水线气泡在单并发下的直接体现,c4到c8才靠batch变大摊薄气泡,跳到45.67。DP的c8出现了反常:36.97 → 32.97不升反降,后面节会专门拆解。
(三)延迟与单请求速度
表2 mean TPOT与单请求decode估算(单请求= 1000/mean TPOT,tok/s)
| 并发 | 单卡TPOT/单请求 | TP TPOT/单请求 | PP TPOT/单请求 | DP TPOT/单请求 |
|---|---|---|---|---|
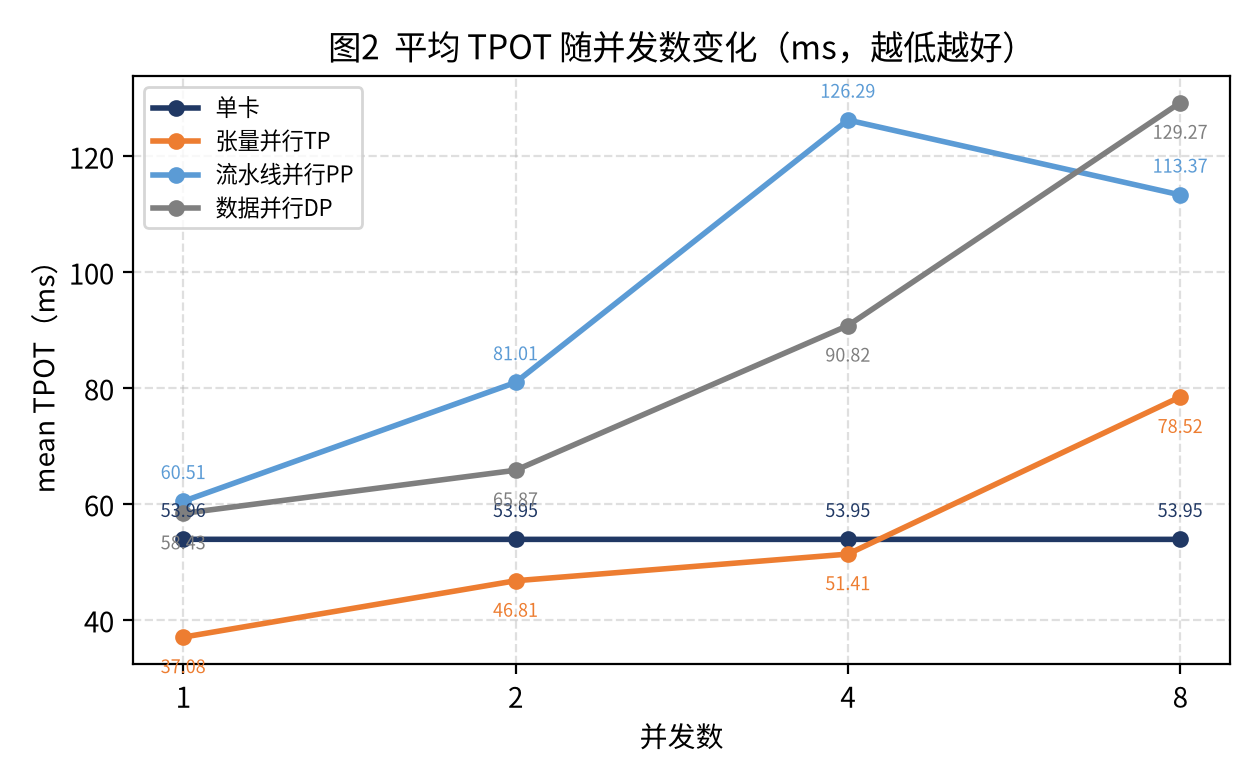
| c1 | 53.96ms/18.53 | 37.08ms/26.97 | 60.51ms/16.53 | 58.43ms/17.11 |
| c2 | 53.95ms/18.53 | 46.81ms/21.36 | 81.01ms/12.34 | 65.87ms/15.18 |
| c4 | 53.95ms/18.53 | 51.41ms/19.45 | 126.29ms/7.92 | 90.82ms/11.01 |
| c8 | 53.95ms/18.53 | 78.52ms/12.74 | 113.37ms/8.82 | 129.27ms/7.74 |
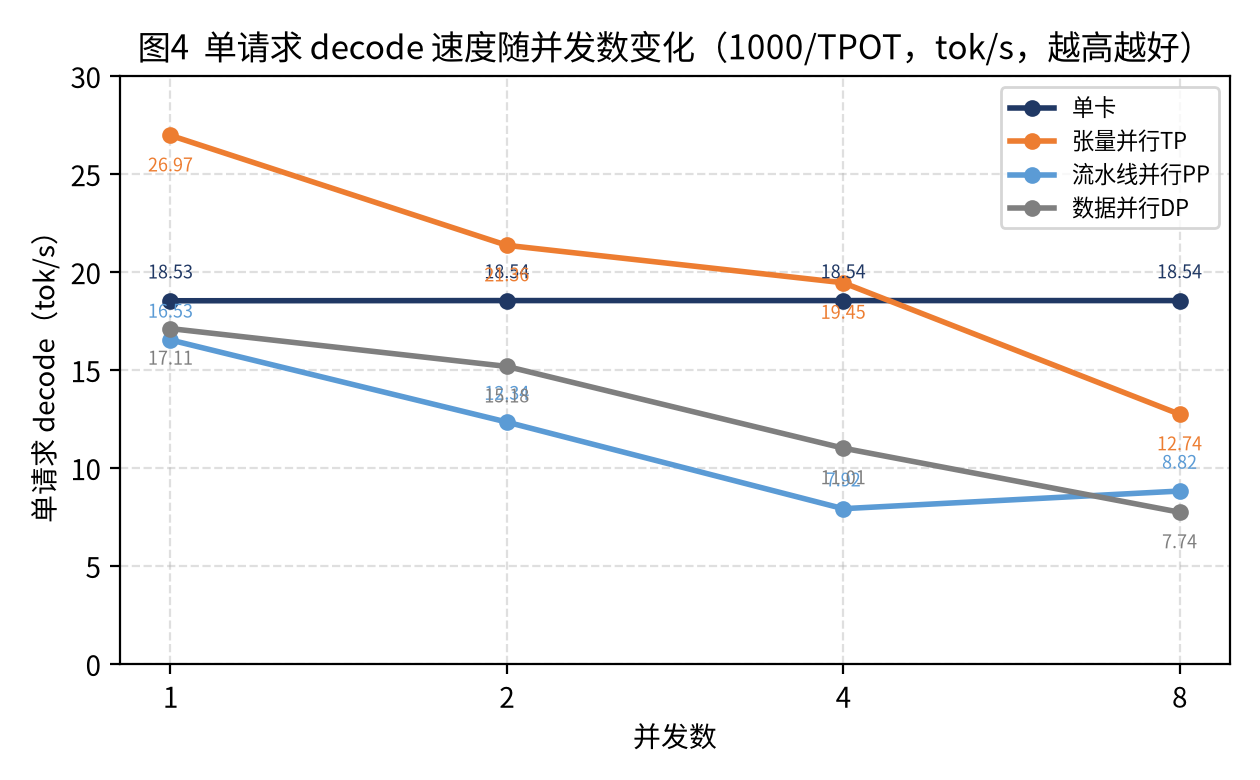

单请求速度(c1,也就是一个用户独占服务时)是真正拉开差距的地方:TP 26.97 tok/s > 单卡18.53 > DP 17.11 > PP 16.53。TP把单请求decode速度拉高了+45.5%(26.97/18.53)——这是因为张量并行下两层权重同时在两张卡上算,单token的算力直接翻倍。PP反而比单卡慢了 −10.8%,流水线气泡让每个token都要串行穿过前后两段;DP与单卡基本持平(−7.7%),因为单请求本来就只打到一张卡上。
mean TPOT随并发恶化的幅度也值得记一笔:单卡0%(它根本不调度,请求一律排队),TP 37.08 → 78.52ms(2.1×),PP 60.51 → 113.37ms(1.9×),DP 58.43 → 129.27ms(2.2×)。
表3 TTFT分布(mean/p95/p99,ms;两轮均值)
| 并发 | 单卡mean | 单卡p95/p99 | TP mean | TP p95/p99 | PP mean | PP p95/p99 | DP mean | DP p95/p99 |
|---|---|---|---|---|---|---|---|---|
| c1 | 1402.3 | 1412.6/1417.8 | 1378.9 | 1381.5/1394.3 | 1590.4 | 1598.9/1627.6 | 1722.8 | 1681.6/3763.7* |
| c2 | 9439.0 | 9662.6/9674.9 | 2123.1 | 2811.5/2834.7 | 2527.6 | 3358.9/3424.6 | 1875.8 | 2458.2/2467.7 |
| c4 | 24905.8 | 26173.5/26190.0 | 4467.6 | 5592.1/5592.3 | 5256.2 | 6586.2/6586.6 | 2138.4 | 3538.3/3546.3 |
| c8 | 56246.2 | 59171.9/59185.2 | 6705.3 | 9588.8/10906.7 | 8004.0 | 11479.7/12864.0 | 12687.6 | 35036.5/35639.6 |
注:DP c1 p99被r1的5862.6ms单点离群拉高。
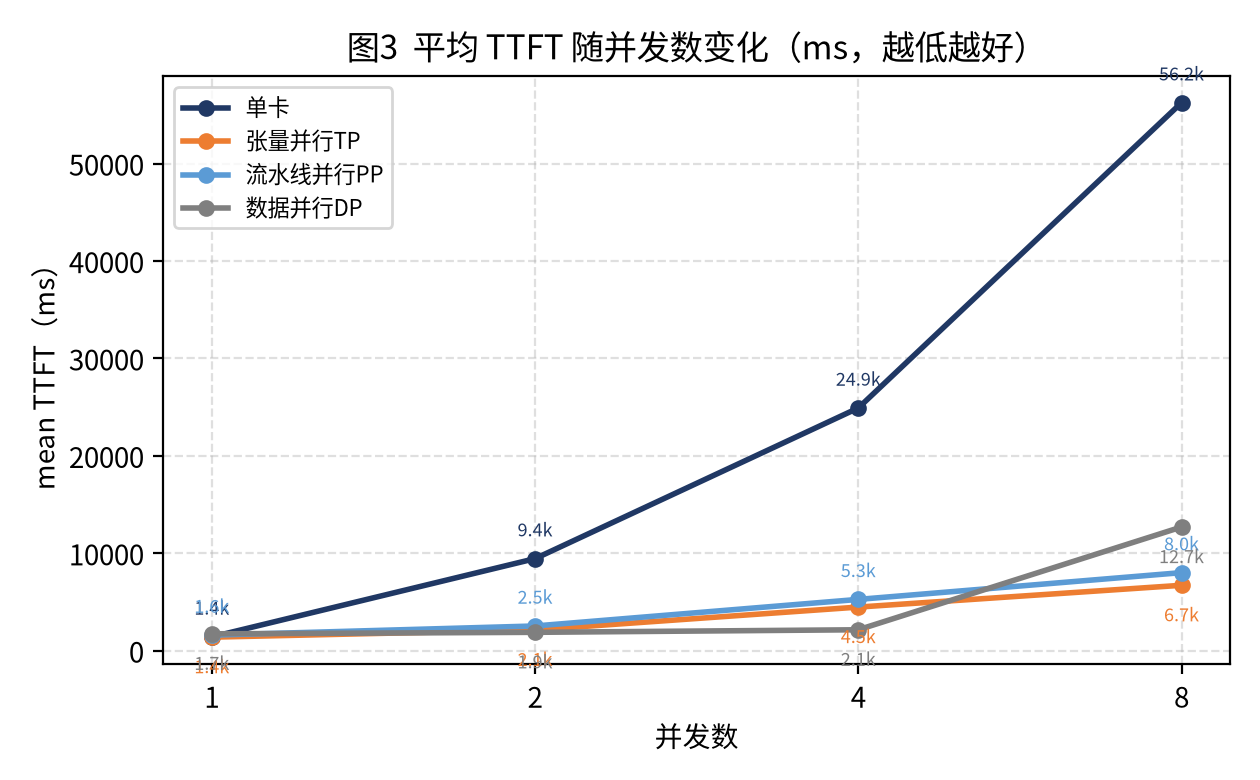
TTFT这张图把 “排队” 两个字看得清清楚楚:单卡c8的mean TTFT是56.25秒,而TP只有6.71秒。原因前面已经说了,单卡加并发只排队,请求在队列里等前面的生成完才轮到prefill;TP算力翻倍,排队长度自然短得多。延迟的长尾也要点名:TP c8两轮的p99 ITL是1438.52/1438.64ms(mean ITL只有78.5ms),PP c8是1730.23/1728.63ms,DP在c4/c8也出现约1703/1723ms的p99 ITL。这种 “均值正常、p99突然1.4~1.7秒” 的尖峰,典型指向跨卡通信(TP的allreduce、PP的send/recv、DP的两实例调度)在高并发下偶发阻塞。
(四)c8加速比:相对单卡到底快多少
| 模式 | c8聚合decode(tok/s) | 加速比 | 理论2×达标? |
|---|---|---|---|
| 张量并行TP | 61.38 | 3.95× | 超额(通信未成为瓶颈) |
| 流水线并行PP | 45.67 | 2.94× | 超额(气泡随batch摊薄) |
| 数据并行DP | 32.97 | 2.12× | 未达标且c8已回撤 |

理论上两张卡理想加速就是2×。TP 3.95×、PP 2.94×都超额了——这说明在27B-FP8这个规模、c8的batching下,PCIe x8之间的allreduce没有把算力吃回来,BMG架构+vLLM XPU的通信效率尚可。DP 2.12×未达标,而且它是四条线里唯一在c8不升反降的,后面细说。
(五)prefill:长输入的第一道坎
| 输入长度 | 单卡 吞吐/TTFT | TP吞吐/TTFT | PP吞吐/TTFT | DP吞吐/TTFT |
|---|---|---|---|---|
| 512 | 1313.9/389.3 | 1380.4/370.8 | 1100.7/465.0 | 1097.2/465.6 |
| 1024 | 1467.7/697.6 | 1457.2/702.6 | 1265.5/809.0 | 1262.5/809.8 |
| 2048 | 1444.3/1417.7 | 1487.0/1377.2 | 1279.1/1601.0 | 1265.1/1618.5 |
| 4096 | 1424.9/2874.4 | 1501.1/2728.5 | 1267.8/3230.8 | 970.5/4220.2 |
| 6144 | 1408.4/4362.4 | 1499.5/4097.1 | 1253.5/4901.2 | 662.2/9277.9 |
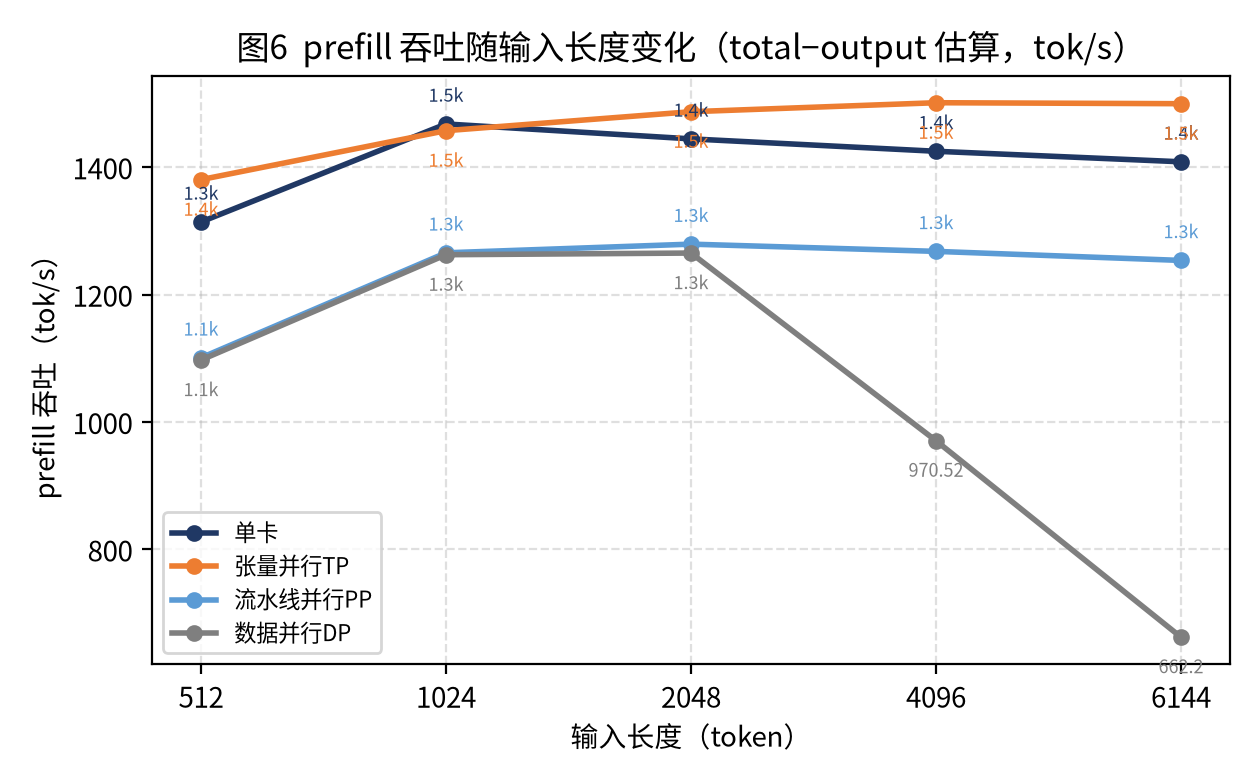
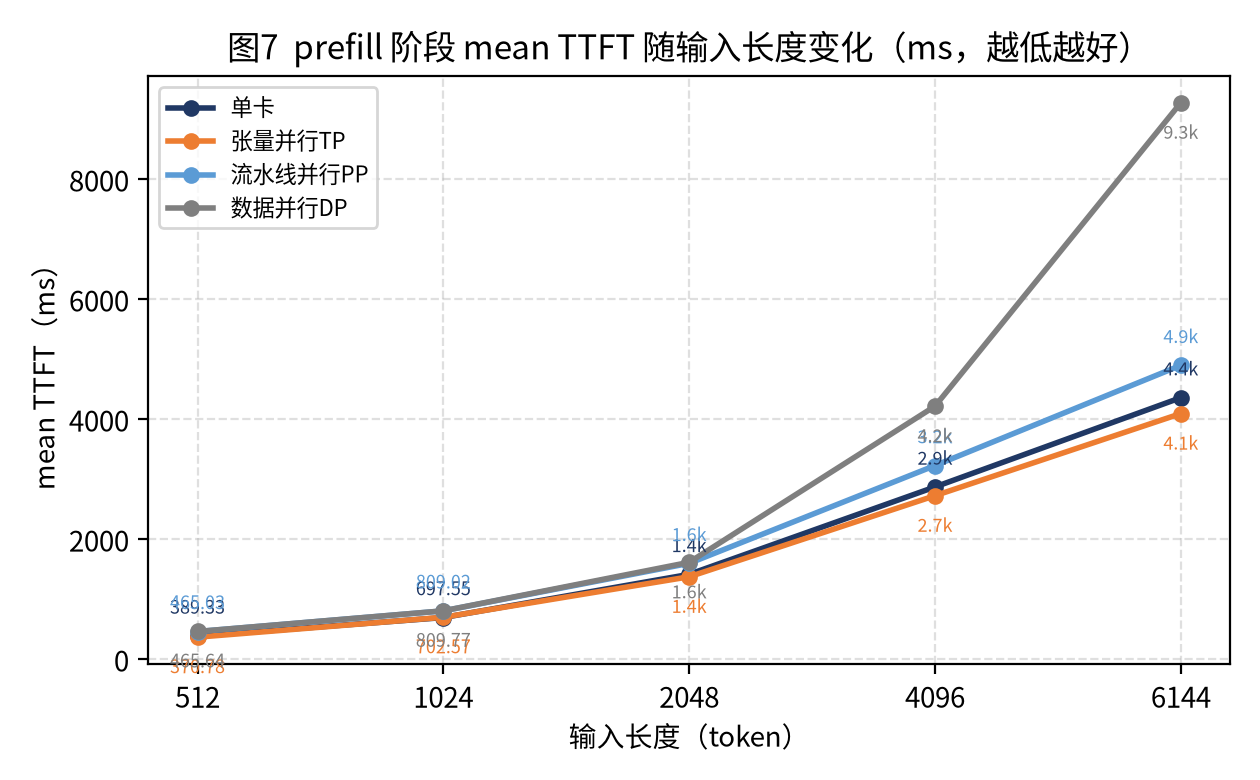
prefill吞吐排序很干净:TP约1490 > 单卡约1417 > PP约1254 tok/s。脚本用512→6144两端点算出的TTFT斜率(1511/1418/1270 tok/s)与服务级估算互相吻合,说明这个排序是可靠的。在单卡/TP/PP上,TTFT随输入长度近似线性增长(每token约0.66~0.79ms),没有出现非线性爆点。
DP在这里掉了链子:4096时prefill吞吐掉到970.5、6144更是只有662.2 tok/s(TP同长度仍有约1500);6144时mean TTFT 9278ms、median 11619ms,实测持续时长92.78秒。前2048长度内DP与PP几乎重合,一到长prompt就明显退化——怀疑是单引擎显存/KV压力或路由倾斜,这也与 “DP上下文上限约8K” 的判断互相印证。
测试过程中还遇到有三类异常,一并写出来,避免只看均值被误导:第一是高并发长尾,TP c8的p99 ITL两轮1438.52/1438.64ms(mean仅78.5ms)、PP c8 1730.23/1728.63ms、DP c4/c8约1703/1723ms——跨卡通信在c8下的偶发阻塞;第二是DP c2的轮次间波动,r1=21.87 vs r2=28.45 tok/s,相差30%;第三是DP c8的回撤与双峰:聚合decode 32.97低于c4的36.97,mean TTFT 12688ms但median只有5883ms、p95 TTFT高达35037ms——典型的两引擎负载不均、其中一个变慢,请求被分到慢引擎上就形成双峰分布。
(六)显存质变:8K与128K的区别
单卡与DP部署下,32GB装进27B-FP8权重后,KV余量大约只够8K上下文,再往上直接OOM;本次prefill扫到6144 + output 1仍在8K以内,DP在4096/6144的退化也与这个上限吻合。
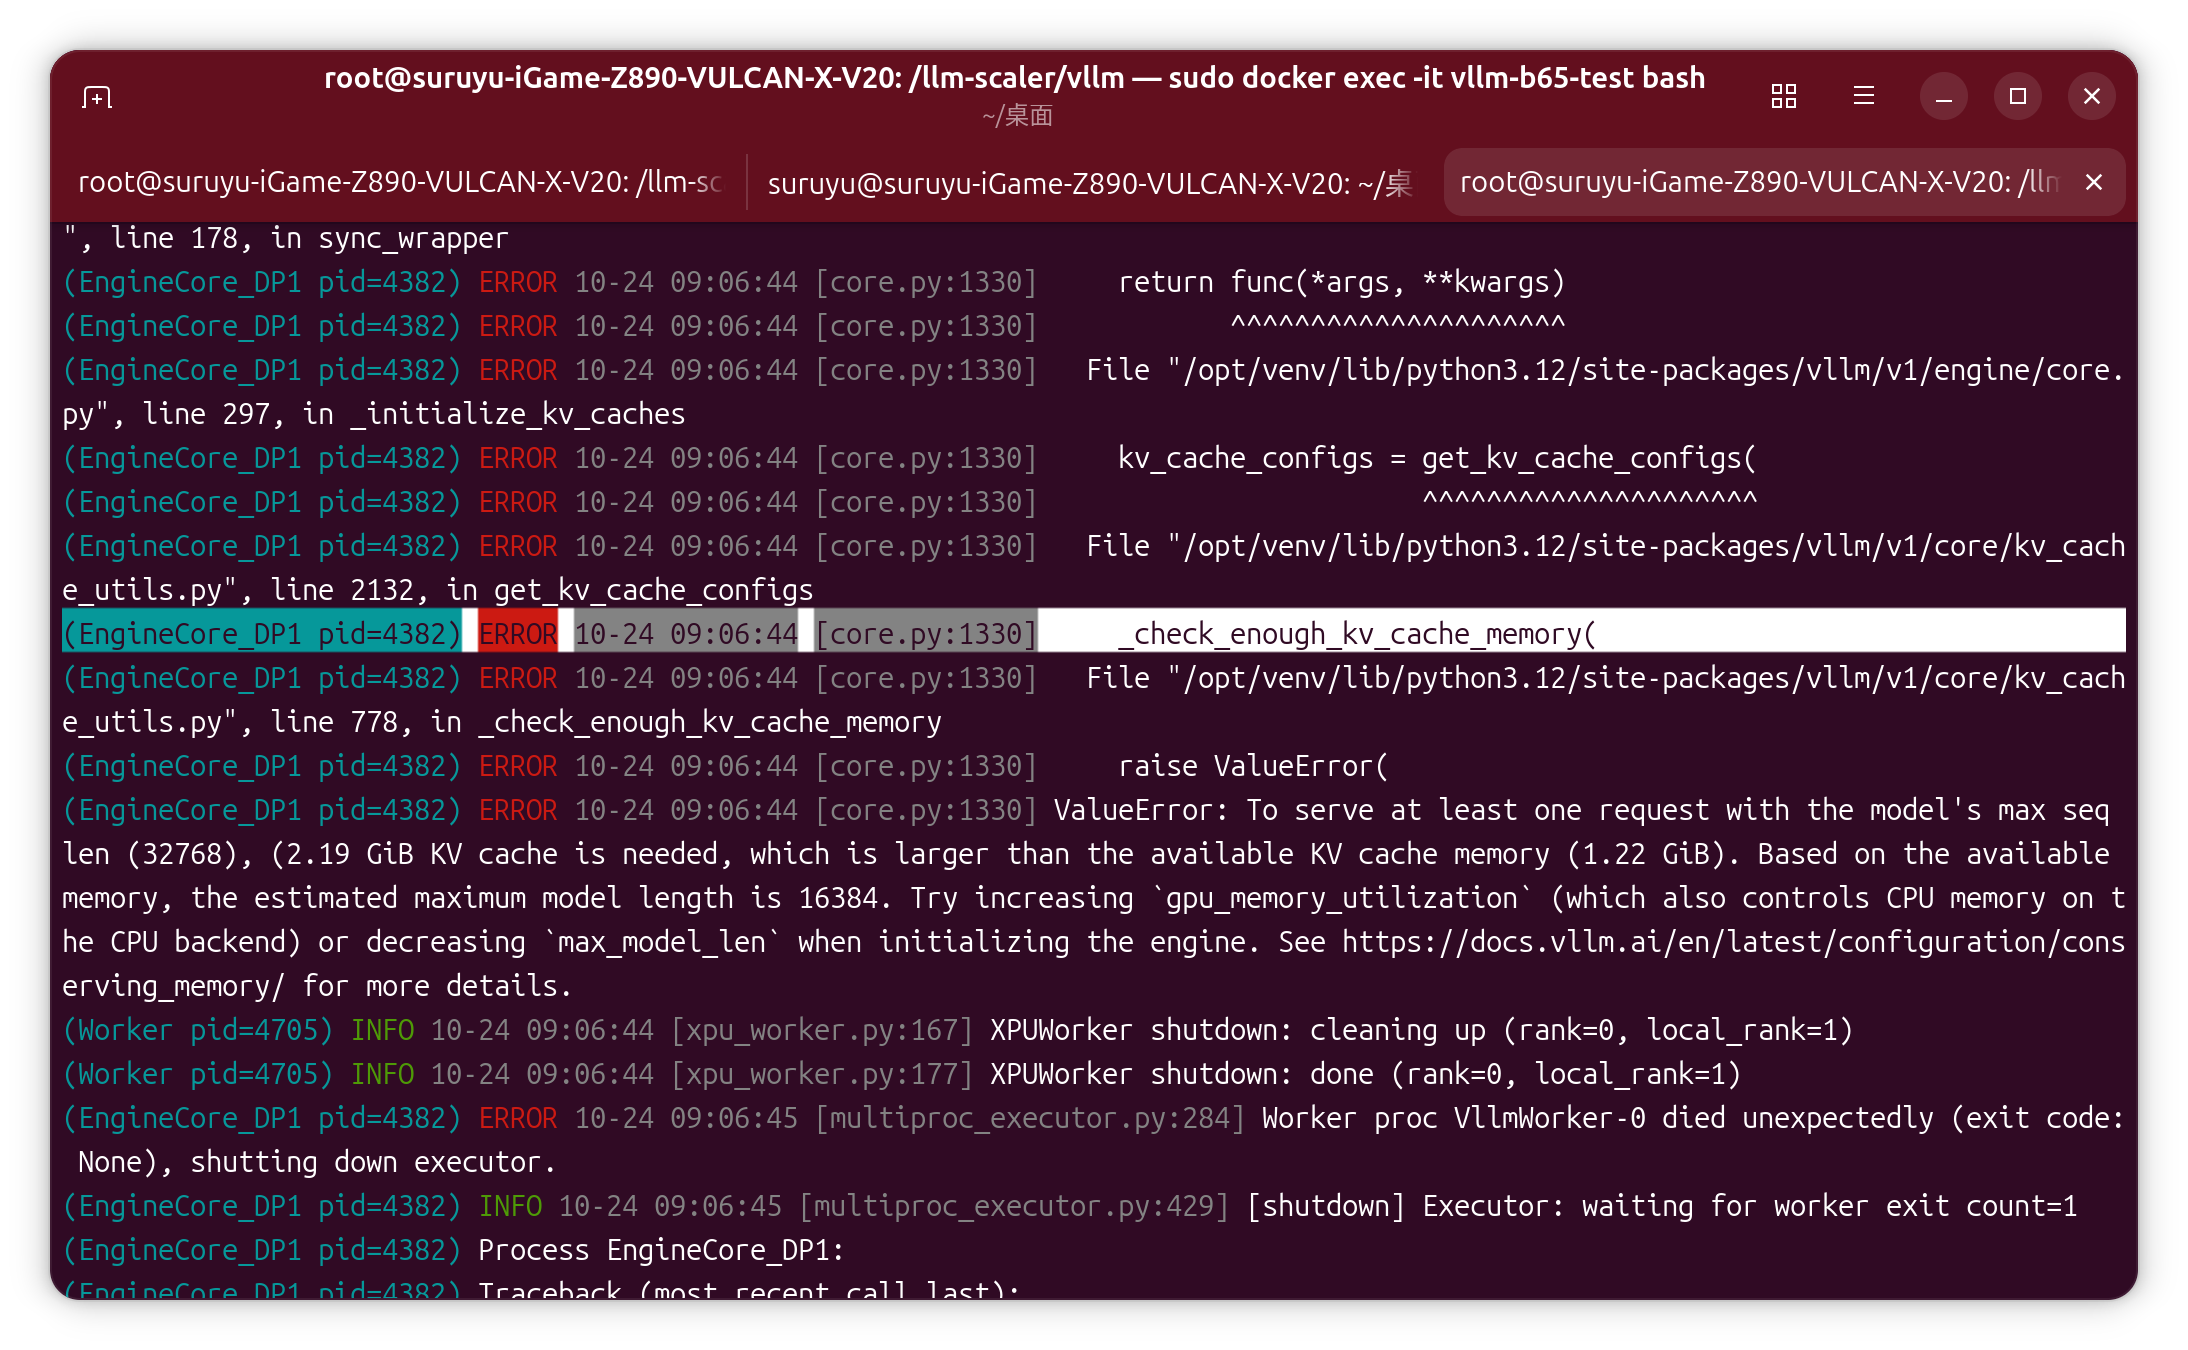
即使用8K的上下文勉强启动,在接入Deepseek Harnes这类智能体之后也很难正常使用。
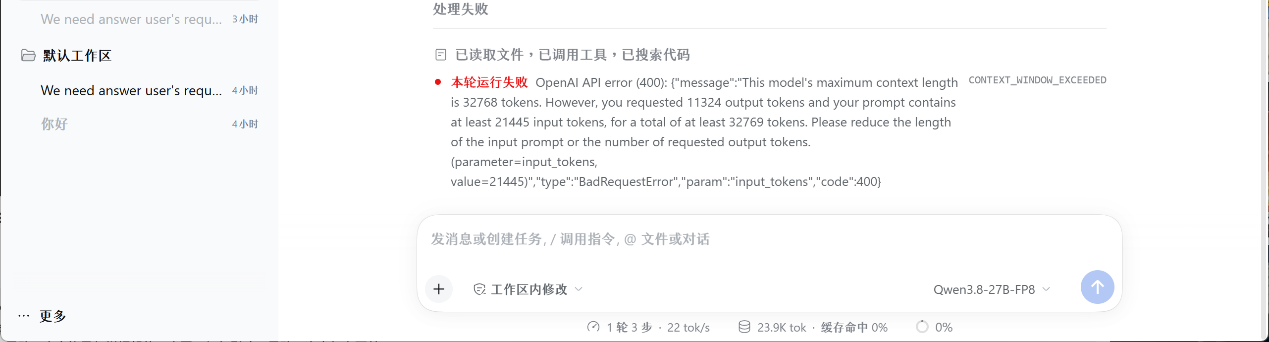
而TP/PP把权重与KV切到两张卡,单卡负担减半,上下文可以一路开到128K以上,这对长文档RAG、长代码库分析这类场景,这才是双卡真正的理由,而不是把15.5 tok/s堆到61 tok/s。接入Deepseek Harness智能体之后也可以长时间稳定运行,不过我们也可以发现的单个任务是无法达到刚才测试的理论上限,还可以给多个用户提供余量。
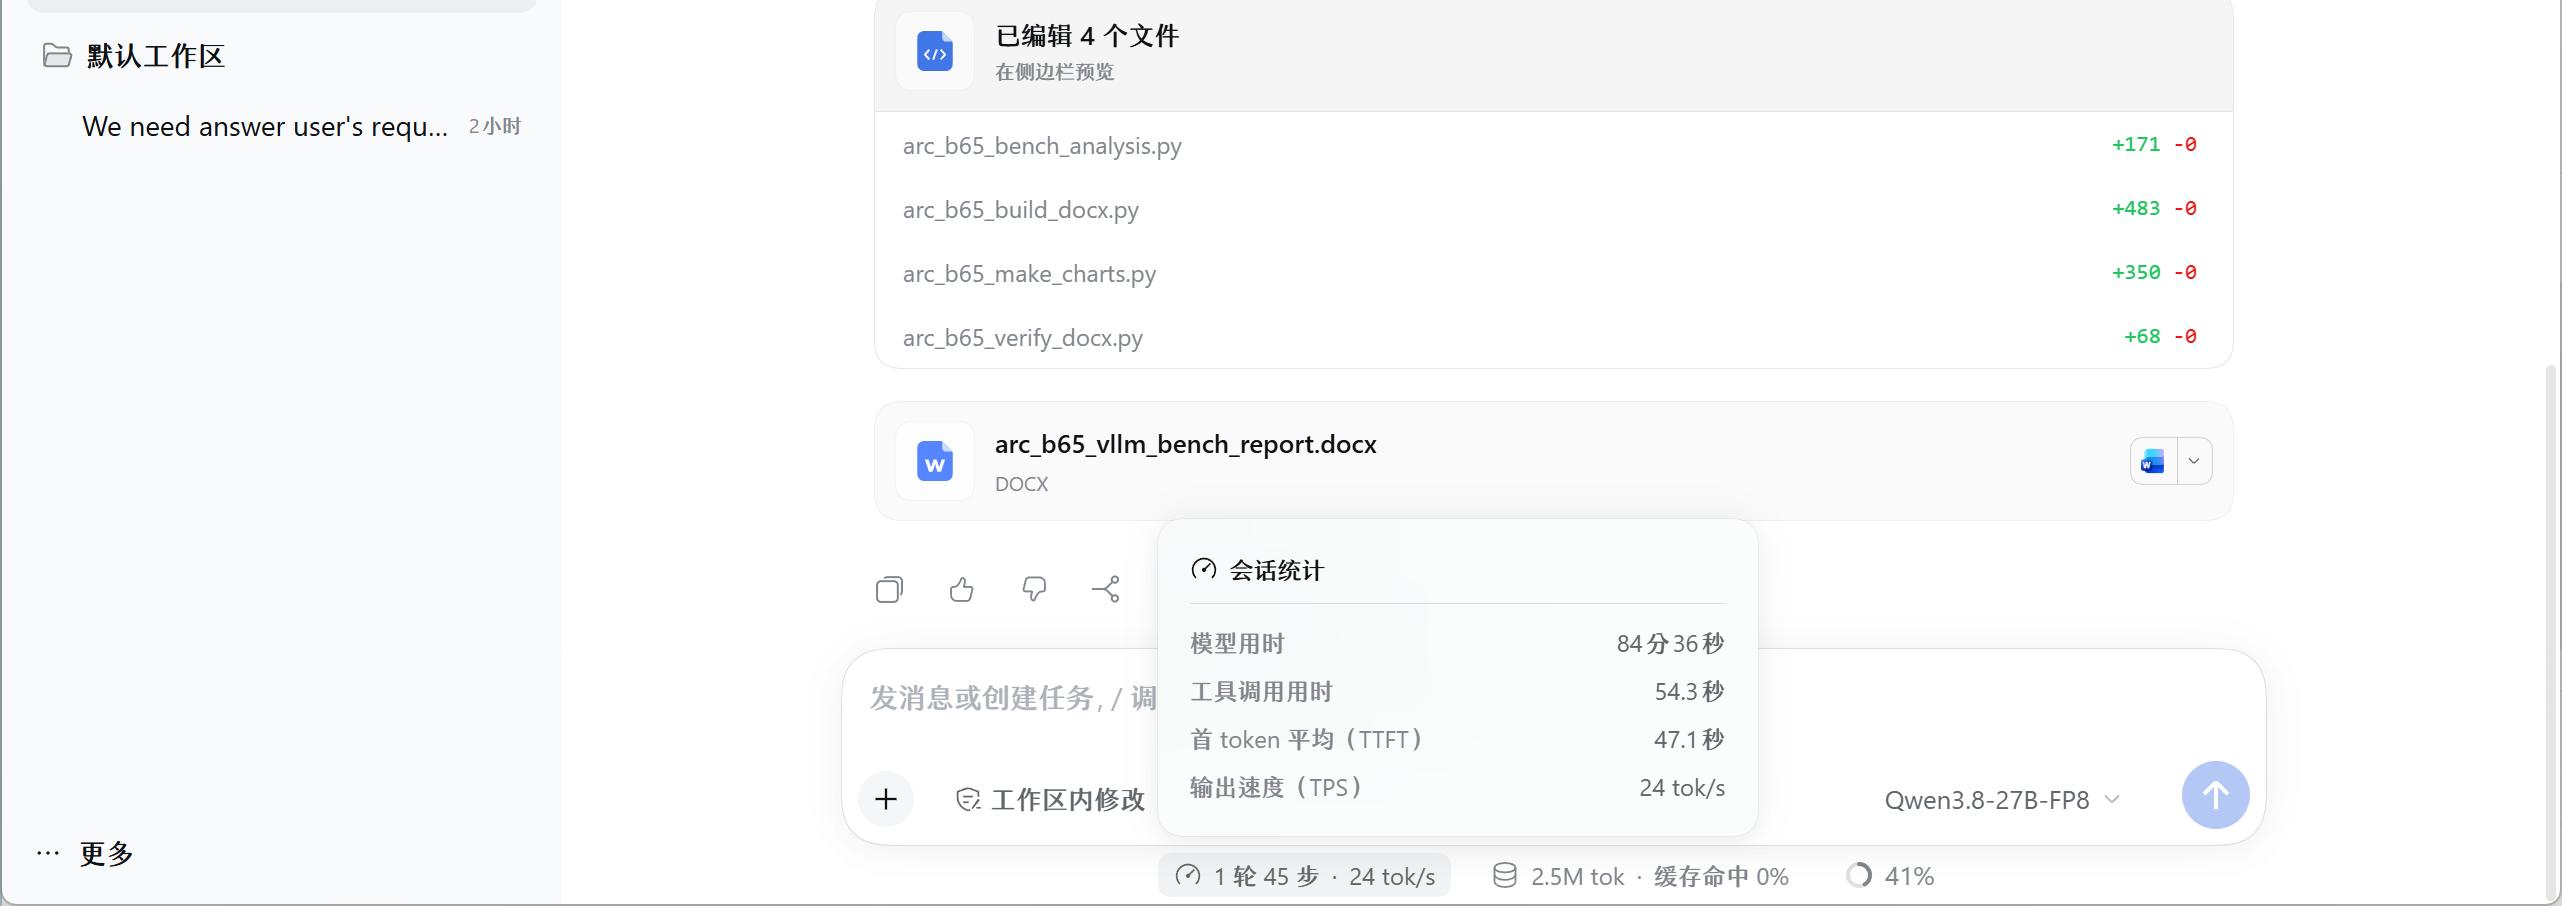
这也从侧面进一步说明了双卡真正的理由,并不仅仅是把理论的吞吐量从15.5 tok/s堆到61 tok/s,更大的上下文长度同样重要。
四、总结
看完上面的测试,想必大家心里都有了一杆秤。
追求单请求速度,选TP:26.97 tok/s,比单卡+45.5%;追求稳定的高并发吞吐,还是选TP,c8聚合61.38 tok/s、相对单卡3.95×,两条关键档位它都是最优。
PP的定位是 “用单请求慢换上下文长”,它也是显存叠加、能开128K,但c1单请求只有16.53 tok/s、比单卡还慢,只适合对单token延迟不敏感、主要跑长文档的离线批处理。
DP在这套B65环境下的数据不支持推荐——轮次间30%波动、c8回撤、长序列退化三项异常同时出现,“每卡一份整模” 的简单架构并没有换来简单的稳定性。
单卡则回到它本来的位置,32GB够用、8K以内、算力打满就排队的桌面推理。
两张蓝戟Arc Pro B65 32G组双卡,拿到的是 “64GB可用显存+约1.9倍单请求算力+ c8约4倍聚合吞吐”,在这个显存贵上天的时代已经显得弥足珍贵。虽然桌面PCIe 5.0 x8+x8(约31.5GB/s×2)的互联,远不如NVLink,但在27B-FP8这个规模上allreduce没有成为瓶颈。它最适合的人群是本地跑27B及以上量化模型、需要128K以上的上下文长文档/RAG用户,以及想在工作站上低成本堆显存、而不是买一张天价的专业大显存卡的人。